

Qu'est-ce que l'analyse prédictive ?
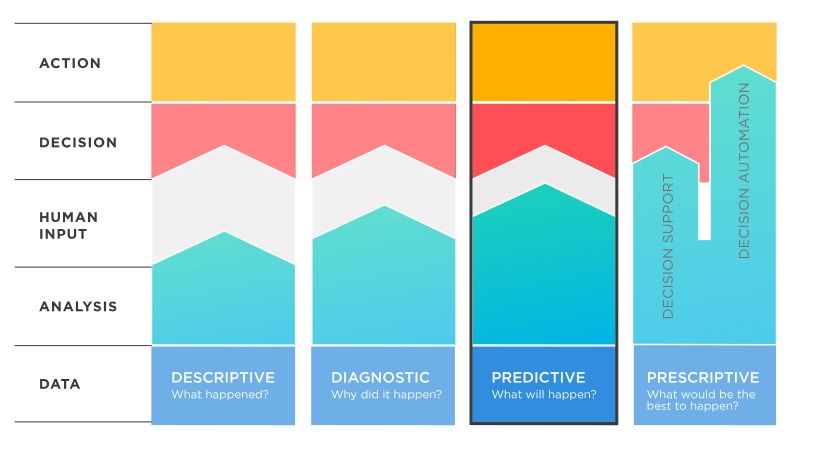
L’analyse prédictive est une approche analytique axée sur les données, utilisée pour prévoir les résultats ou les tendances futurs sur la base de données historiques et actuelles. Elle implique l’application d’algorithmes statistiques, de techniques d’apprentissage automatique et de méthodes d’exploration de données pour analyser les modèles de données, identifier les relations et faire des prédictions. En exploitant les données historiques et en extrayant des informations précieuses, l’analyse prédictive permet aux organisations de prendre des décisions éclairées, d’optimiser les processus et d’atténuer les risques.
Concepts clés de l’analyse prédictive
L’analyse prédictive s’appuie sur certains concepts fondamentaux qui constituent ses éléments de base. Ces concepts sont essentiels pour comprendre comment elle fonctionne et pourquoi elle est un outil précieux dans différents domaines. Voici quelques-uns des concepts clés associés à l’analyse prédictive :
Modélisation prédictive
La modélisation prédictive est l’élément central de l’analyse prédictive. Il s’agit d’utiliser des données historiques pour construire des modèles mathématiques et statistiques qui, à leur tour, permettent de prévoir des événements ou des tendances futurs.
Ces modèles peuvent varier en complexité, depuis les régressions linéaires de base, qui identifient des relations simples dans les données, jusqu’aux algorithmes d’apprentissage automatique plus complexes, capables de traiter divers modèles de données.
L’essence de la modélisation prédictive réside dans sa capacité à identifier et à quantifier des modèles dans des données historiques. L’examen minutieux des modèles de données permet d’identifier les variables significatives et leurs relations qui affectent le résultat prévu. Cet exercice analytique permet aux organisations d’exploiter efficacement les données, d’anticiper les tendances futures, d’affiner leurs stratégies et de prendre des décisions éclairées qui renforcent leur position concurrentielle.
Data mining
L’exploration de données consiste à découvrir des modèles cachés, des connexions et des informations précieuses dissimulées dans de vastes ensembles de données. Dans l’analyse prédictive, les techniques d’exploration de données sont des outils indispensables pour extraire des informations précieuses des données, formant ainsi la base de la construction de modèles prédictifs.
Au fond, le data mining agit comme un détective numérique, examinant méticuleusement de vastes ensembles de données afin d’en extraire des informations précieuses. Ces informations peuvent inclure des tendances, des corrélations ou des relations précédemment passées inaperçues dans les données. En identifiant ces joyaux cachés, le data mining donne aux organisations les moyens de créer des modèles prédictifs plus précis, améliorant ainsi leur capacité à prévoir les événements futurs et à prendre des décisions en connaissance de cause.
Machine learning
L’apprentissage automatique est un domaine spécialisé de l’intelligence artificielle (IA) qui se concentre sur la création d’algorithmes. Ces algorithmes permettent aux ordinateurs d’apprendre à partir de données et de faire des prédictions ou de prendre des décisions de manière autonome. Dans le contexte de l’analyse prédictive, l’apprentissage automatique joue un rôle central en exploitant la puissance de ces algorithmes pour améliorer la précision des prédictions.
L’apprentissage automatique ne suit pas de règles rigides et préprogrammées ; il apprend plutôt à partir de modèles et d’exemples contenus dans les données. Cette capacité d’apprentissage permet aux machines d’améliorer leurs prévisions au fur et à mesure qu’elles reçoivent des informations. C’est comme apprendre à un ordinateur à reconnaître l’écriture manuscrite ou à prédire si un courriel est du spam.
Dans l’analyse prédictive, les algorithmes d’apprentissage automatique analysent les données historiques, découvrent des modèles et utilisent ces connaissances pour prédire des événements ou des résultats futurs. Les algorithmes aident les organisations à prendre des décisions plus éclairées et à anticiper les tendances avec plus de précision en affinant continuellement leurs prédictions au fur et à mesure qu’elles reçoivent de nouvelles données.
Analyse de régression
L’analyse de régression est une technique statistique utilisée dans l’analyse prédictive pour comprendre comment une ou plusieurs variables indépendantes sont liées à une variable dépendante. Son objectif principal est de mesurer l’impact des variables indépendantes sur le résultat prévu.
- Variables indépendantes : Ces facteurs ou variables peuvent influencer le résultat que nous voulons prédire. Par exemple, si nous voulons prédire le salaire d’une personne, les variables indépendantes peuvent inclure les années d’expérience, le niveau d’éducation et l’intitulé du poste.
- Variable dépendante : Il s’agit du résultat que nous cherchons à prédire, par exemple le salaire d’une personne.
L’analyse de régression nous aide à quantifier la relation entre les variables indépendantes et dépendantes. Elle calcule comment les changements de chaque variable indépendante affectent la variable dépendante. Par exemple, elle peut nous indiquer dans quelle mesure une augmentation d’un an de l’expérience contribue à une modification du salaire.
En utilisant l’analyse de régression dans l’analyse prédictive, les organisations obtiennent une compréhension précise de l’impact des différents facteurs sur les résultats qu’elles veulent prédire. Ces connaissances leur permettent de faire des prévisions plus précises et de prendre des décisions éclairées sur la base d’informations fondées sur des données.
{{cta-1}}
Le processus d’analyse prédictive
L’analyse prédictive est un processus structuré qui comprend plusieurs étapes séquentielles, chacune ayant un objectif spécifique. Il est essentiel de comprendre ce processus pour exploiter efficacement la puissance des données afin de faire des prévisions et de prendre des décisions en connaissance de cause. Le processus d’analyse prédictive se déroule généralement comme suit :
Collecte des données
La collecte de données est le point de départ fondamental de l’analyse prédictive. Au cours de cette phase, l’objectif principal est de recueillir des données pertinentes à partir de diverses sources, notamment des bases de données, des enquêtes, des sources en ligne ou d’autres sources d’information. Ces données collectées constituent le socle sur lequel sont construits les modèles prédictifs.
Voici un examen plus approfondi des aspects clés de cette étape :
Source Diversité
Les données peuvent provenir de nombreux endroits à l’intérieur et à l’extérieur d’une organisation. Il peut s’agir de dossiers de clients, de transactions financières, de relevés de capteurs, d’interactions avec les médias sociaux ou de toute autre information pertinente permettant d’éclairer la tâche prédictive. La diversité des sources de données permet une compréhension globale des facteurs influençant la prédiction.
Fondation pour les modèles
Les données recueillies au cours de cette phase ne sont pas simplement une collection de chiffres ; elles représentent les phénomènes ou les comportements du monde réel que nous cherchons à comprendre et à prévoir. Ces données deviennent la matière première à partir de laquelle les modèles prédictifs sont élaborés. La qualité et la richesse des données ont un impact direct sur la précision et la fiabilité des prévisions ultérieures.
Qualité et quantité
La qualité des données est primordiale. Il s’agit de s’assurer que les données sont exactes, complètes et exemptes d’erreurs ou d’incohérences. La quantité de données est également importante (il est essentiel de disposer d’un nombre suffisant de données pour élaborer des modèles prédictifs robustes). Des données inadéquates ou de mauvaise qualité peuvent conduire à des prévisions peu fiables.
Prétraitement des données
Après la collecte des données, la prochaine étape cruciale de l’analyse prédictive est le prétraitement des données. Cette phase consiste à présenter les données collectées sous une forme propre, cohérente et utilisable pour l’analyse. Les principaux objectifs sont de traiter les valeurs manquantes, les valeurs aberrantes et de normaliser les formats de données. Cela garantit la fiabilité des données, ce qui permet de faire des prévisions précises.
Voici les principales tâches du prétraitement des données :
- Gestion des valeurs manquantes : Les données réelles comportent souvent des lacunes ou des valeurs manquantes. Le prétraitement des données implique des stratégies visant à combler ces lacunes ou à supprimer les enregistrements incomplets afin de ne pas compromettre l’analyse.
- Gestion des valeurs aberrantes : Les valeurs aberrantes sont des points de données extrêmes qui peuvent fausser les résultats de l’analyse. Le prétraitement des données permet d’identifier et de traiter les valeurs aberrantes en les supprimant ou en modifiant leur impact.
- Normaliser les données : Les données peuvent se présenter sous différents formats et unités. La normalisation des formats de données, par exemple en veillant à ce que toutes les mesures utilisent la même unité, simplifie l’analyse et permet des comparaisons significatives.
- Normalisation et mise à l’échelle : Parfois, les données doivent être transformées pour correspondre à une échelle standard. La normalisation et la mise à l’échelle permettent d’ajuster les variables numériques à une fourchette cohérente, en veillant à ce que les variables ayant des échelles différentes ne dominent pas l’analyse.
- Codage des variables catégorielles : Les ensembles de données contiennent souvent des variables catégorielles telles que « oui/non » ou « rouge/bleu/vert ». Le prétraitement des données comprend des techniques de conversion de ces variables en valeurs numériques compatibles avec les modèles analytiques.
Construction de modèles
La construction de modèles est au cœur de l’analyse prédictive, où le processus passe de la préparation des données à l’élaboration de prédictions. Les modèles mathématiques et statistiques sont élaborés à partir des données soigneusement préparées au cours de cette phase.
Ces modèles peuvent couvrir un large spectre, allant de simples régressions linéaires à des algorithmes d’apprentissage automatique plus complexes. La sélection du modèle le plus approprié dépend de la nature des données et de l’objectif prédictif spécifique.
Voici un aperçu de ce qui se passe lors de la construction d’une maquette :
Élaboration de modèles prédictifs
Les modèles prédictifs sont des outils mathématiques capables de discerner des modèles et des relations dans les données. Ils sont conçus pour saisir la structure sous-jacente des données, ce qui leur permet de faire des prédictions éclairées. Les modèles utilisent les modèles identifiés lors de l’analyse des données pour comprendre comment les différentes variables influencent les résultats prévus.
Modèle de diversité
L’analyse prédictive offre une boîte à outils composée de différentes techniques de modélisation. Les modèles simples comme les régressions linéaires conviennent lorsque la relation entre les variables est relativement simple.
D’autre part, les algorithmes complexes d’apprentissage automatique tels que les arbres de décision ou les réseaux neuronaux peuvent traiter des modèles de données complexes et des relations non linéaires. Le choix du modèle dépend de la complexité du problème et des données disponibles.
Personnalisation
La construction de modèles consiste à adapter le modèle sélectionné au problème spécifique. Il peut s’agir d’affiner les paramètres, de définir les variables d’entrée et de déterminer la variable cible. L’objectif est de rendre les prédictions du modèle aussi précises que possible.
Formation du modèle
Une fois le modèle mis en place, il est « formé » à l’aide de données historiques. Au cours de la formation, le modèle apprend à partir des modèles et des relations au sein des données, et s’adapte pour prédire les résultats futurs.
Évaluation du modèle
Une fois les modèles prédictifs construits, l’évaluation du modèle est l’étape critique suivante du processus d’analyse prédictive. Cette phase s’apparente à un contrôle de qualité, où l’efficacité et la fiabilité des modèles sont rigoureusement évaluées.
L’évaluation d’un modèle implique l’utilisation de mesures et de techniques spécifiques pour mesurer l’adéquation entre les prédictions du modèle et les données du monde réel. Les mesures d’évaluation courantes comprennent l’exactitude, la précision, le rappel et le score F1. Cette évaluation est essentielle pour déterminer si le modèle est adapté à la tâche prédictive prévue et si des ajustements ou des améliorations sont nécessaires.
Voici un aperçu de ce qui se passe lors de l’évaluation d’un modèle :
Mesures de performance
Diverses mesures de performance sont utilisées pour évaluer la performance d’un modèle prédictif. Ces paramètres fournissent des mesures quantitatives de la performance du modèle. En voici quelques-unes :
- Précision : Mesure la proportion de prédictions correctes faites par le modèle.
- Précision : Indique le nombre de prédictions positives faites par le modèle qui sont correctes.
- Rappel : Mesure la proportion de cas positifs réels que le modèle a correctement prédits.
- Score F1 : Combine la précision et le rappel en une seule mesure, fournissant une évaluation équilibrée de la performance du modèle.
Comparaison avec des données réelles
Lors de l’évaluation du modèle, les prévisions du modèle sont comparées aux données réelles. Il s’agit de tester le modèle avec un ensemble de données distinct (non utilisé pendant la formation) afin d’évaluer sa capacité à faire des prédictions précises sur des données inédites.
Ajustements et améliorations
En fonction des résultats de l’évaluation, des ajustements du modèle peuvent s’avérer nécessaires. Il peut s’agir de modifier les paramètres du modèle, d’en changer l’architecture, voire de choisir une autre approche de modélisation si l’approche actuelle n’est pas performante.
Itération
L’évaluation des modèles donne souvent lieu à un processus itératif. Les modèles sont affinés et réévalués jusqu’à ce que leur performance atteigne le niveau souhaité de précision et de fiabilité.
L’évaluation des modèles est un point de contrôle essentiel de l’analyse prédictive. Il garantit que les modèles créés sont fonctionnels et efficaces pour faire des prédictions précises. Les organisations peuvent affiner leurs modèles et apporter les améliorations nécessaires en utilisant des mesures de performance et en comparant les prédictions des modèles aux données réelles.
Déploiement
Une fois qu’un modèle prédictif a été développé et évalué avec succès, la phase cruciale suivante du processus d’analyse prédictive est le déploiement. Le déploiement est le moment où le modèle est mis en œuvre et devient partie intégrante des opérations de l’organisation.
Cette phase consiste à intégrer le modèle dans les systèmes ou les processus de l’organisation, ce qui lui permet de faire des prévisions en temps réel et d’éclairer la prise de décision. Un déploiement efficace garantit que les précieuses informations prédictives dérivées du modèle sont mises en pratique afin d’améliorer l’activité et d’optimiser les processus.
Voici un aperçu de ce qui se passe lors du déploiement d’un modèle :
- Intégration : Le modèle développé est intégré dans les systèmes ou processus existants de l’organisation. Il peut s’agir de l’intégrer dans les applications logicielles, les bases de données ou les outils d’aide à la décision de l’organisation.
- Prédictions en temps réel : Une fois déployé, le modèle fonctionne en temps réel, faisant des prédictions sur les nouvelles données dès qu’elles sont disponibles. Par exemple, un modèle prédictif de détection des fraudes pourrait analyser chaque transaction entrante pour y déceler une fraude potentielle.
- L’automatisation : L’automatisation est un aspect essentiel du déploiement. Le modèle prédictif fonctionne de manière autonome, en analysant en permanence et en faisant des prédictions sans intervention manuelle.
- Prise de décision éclairée : Les prévisions générées par le modèle sont utilisées pour éclairer les processus de prise de décision au sein de l’organisation. Par exemple, un modèle de gestion des stocks peut prévoir le moment où certains produits sont susceptibles d’être en rupture de stock, ce qui permet de prendre des décisions de réapprovisionnement en temps utile.
- Surveillance et maintenance : Même après le déploiement, il est essentiel d’assurer un suivi et une maintenance continus. Cela permet de s’assurer que le modèle continue à fonctionner avec précision au fil du temps. Des ajustements peuvent être nécessaires si les performances du modèle se détériorent ou si les modèles de données changent.
- Boucle de rétroaction : Le déploiement établit souvent une boucle de rétroaction, dans laquelle les prévisions et les résultats du modèle sont comparés en permanence. Cette boucle de rétroaction permet d’affiner le modèle et d’en améliorer la précision.
{{cta-3}}
Applications de l’analyse prédictive
L’analyse prédictive est un outil polyvalent et puissant qui trouve des applications dans divers secteurs. Voici quelques domaines clés où l’analyse prédictive a un impact significatif :
Affaires et marketing
- Segmentation de la clientèle : L’analyse prédictive aide les entreprises à segmenter leur clientèle en fonction du comportement, des préférences et de l’historique des achats. Cela permet de mener des campagnes de marketing ciblées et de formuler des recommandations personnalisées.
- Prédiction du désabonnement : Les entreprises peuvent prévoir quels clients sont susceptibles de se désabonner (de cesser d’utiliser leurs services) et prendre des mesures proactives pour les conserver.
- Prévision des ventes : Les modèles prédictifs peuvent prévoir les tendances futures des ventes, ce qui permet d’améliorer la gestion des stocks et les stratégies.
Santé
- Diagnostic des maladies : L’analyse prédictive facilite le diagnostic précoce en analysant les données du patient, telles que les symptômes et les antécédents médicaux, afin d’identifier les problèmes de santé potentiels.
- Réadmission des patients : Les hôpitaux utilisent des modèles prédictifs pour prévoir quels patients présentent un risque plus élevé de réadmission, ce qui permet d’allouer les ressources de manière plus efficace.
- Découverte de médicaments : Les entreprises pharmaceutiques utilisent l’analyse prédictive pour accélérer les processus de découverte de médicaments et identifier les candidats potentiels pour des recherches plus approfondies.
Finances
- L’évaluation du crédit : Des modèles prédictifs évaluent la solvabilité d’un individu, permettant aux banques et aux prêteurs de prendre des décisions de prêt en connaissance de cause.
- Détection des fraudes : Les institutions financières utilisent l’analyse prédictive pour détecter les activités frauduleuses en temps réel, empêchant ainsi les transactions non autorisées.
- Prédictions boursières : Les traders et les investisseurs utilisent des modèles prédictifs pour prévoir les cours des actions et prendre des décisions d’investissement.
Industrie manufacturière
- Maintenance prédictive : Les fabricants utilisent l’analyse prédictive pour anticiper le moment où l’équipement ou les machines risquent de tomber en panne, ce qui permet d’effectuer une maintenance en temps voulu et de réduire les temps d’arrêt.
- Contrôle de la qualité : Les modèles prédictifs permettent d’identifier les défauts des produits et les problèmes de qualité au cours de la fabrication.
- Optimisation de la chaîne d’approvisionnement : L’analyse prédictive optimise les opérations de la chaîne d’approvisionnement en prévoyant la demande, en gérant les stocks et en améliorant la logistique.
Sports
- Analyse des performances des joueurs : Les équipes sportives utilisent l’analyse prédictive pour évaluer les performances des joueurs, les risques de blessure et les décisions stratégiques pendant les matchs.
- Engagement des supporters : L’analyse prédictive est utilisée dans le marketing sportif pour comprendre le comportement des supporters et adapter les stratégies d’engagement.
- Recrutement et sélection : Les organisations sportives utilisent des modèles prédictifs pour évaluer les recrues potentielles et les candidats à la sélection sur la base de leurs performances prévues.
Ce ne sont là que quelques exemples de la manière dont l’analyse prédictive révolutionne la prise de décision et les opérations dans divers secteurs. Sa capacité à transformer les données en informations exploitables lui permet d’optimiser les processus, d’améliorer l’expérience des clients et de stimuler l’innovation.
Réflexions finales
L’analyse prédictive est une approche transformatrice qui permet aux organisations de divers secteurs d’activité d’exploiter la puissance des données pour prendre des décisions éclairées, optimiser les processus et améliorer les résultats. Ce domaine dynamique, qui repose sur la collecte de données, le prétraitement, la construction de modèles, l’évaluation et le déploiement, continue d’évoluer grâce à l’intégration d’outils de pointe et de technologies émergentes.
Analyse prédictive avec Jaspersoft

Vous souhaitez essayer ?
Commencez votre essai de 30 jours dès maintenant.
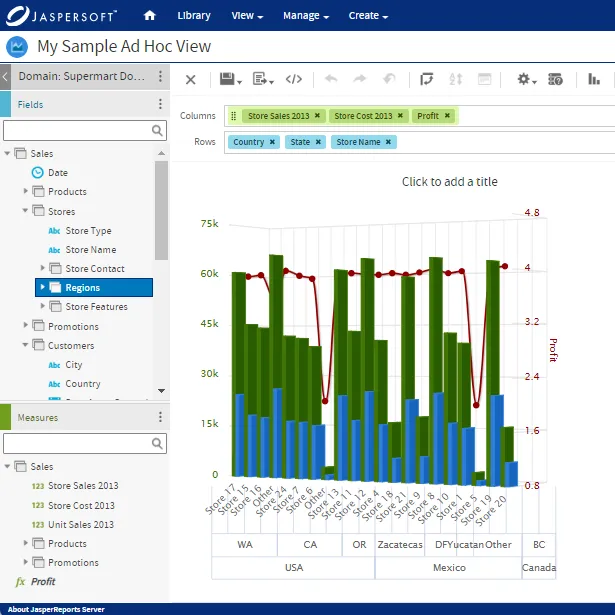
Essayez Jaspersoft - Essai gratuit
Avec Jaspersoft, la principale plateforme d’informatique décisionnelle pour les concepteurs de logiciels, vous pouvez concevoir, intégrer et gérer efficacement des rapports et des analyses.
Build versus Buy: An In-depth Guide
This whitepaper provides a framework for the decision-making process and critical trade-offs between building or buying an embedded BI and reporting tool.
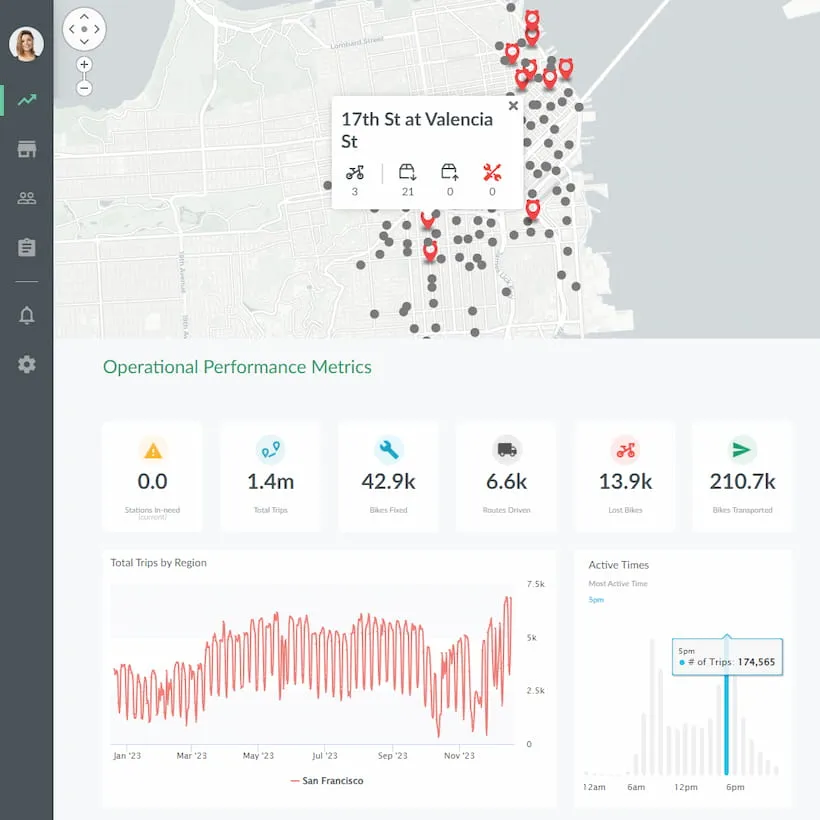
Démonstration gratuite : Bikeshare Embedded BI, supporté par Jaspersoft
Découvrez comment transformer les données en informations précieuses que vous et vos clients pouvez utiliser pour prendre de meilleures décisions.
